Учим API каталога фильтрам, пагинации и честным ошибкам
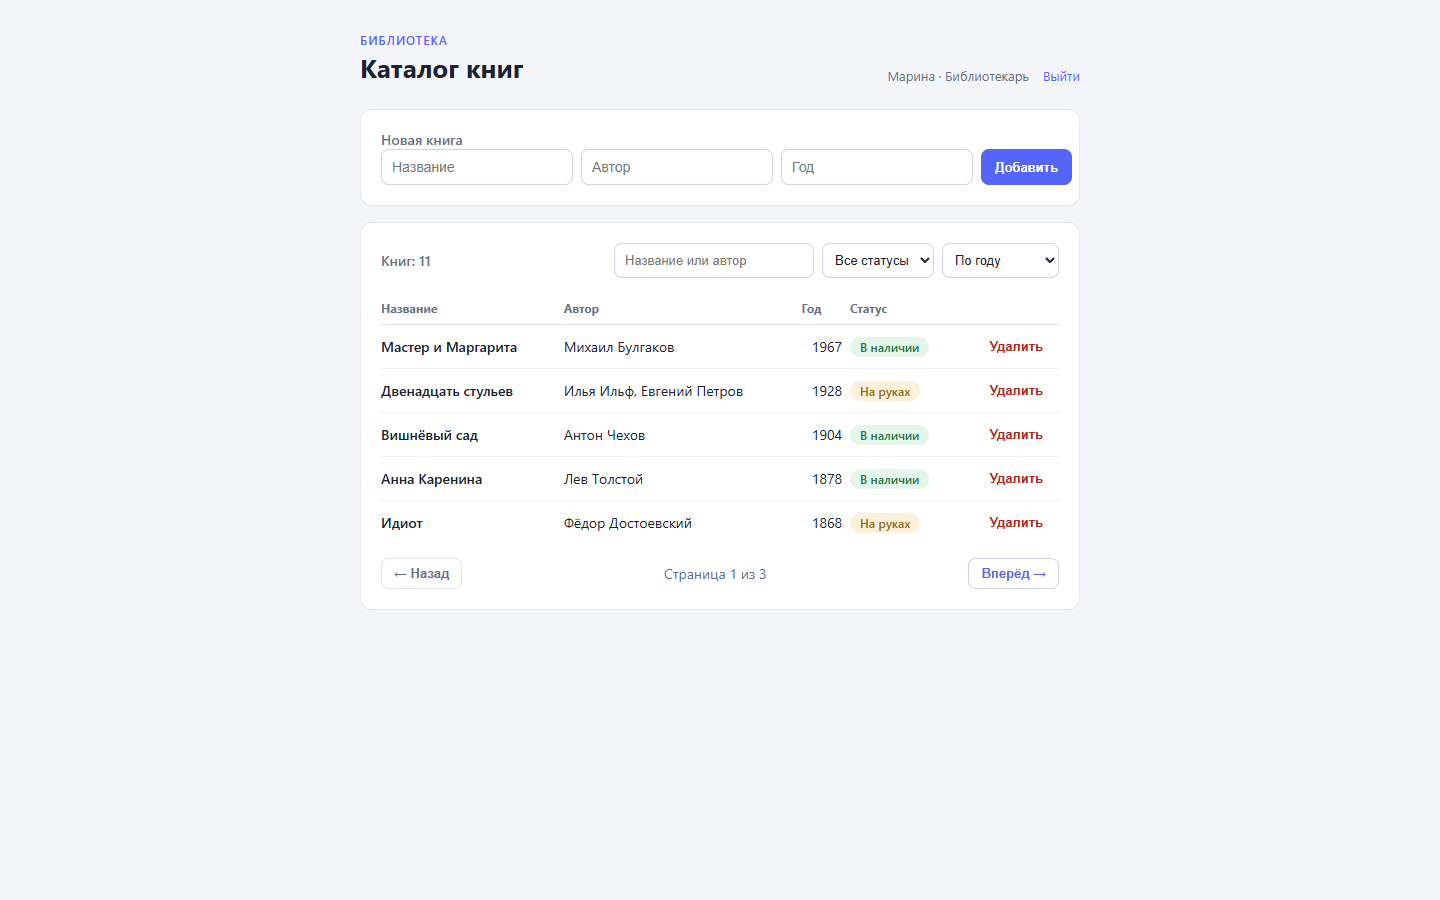
Каталог живёт по сценарию уже две статьи: в первой он получил JSON-API и закрытую админку на Vue, во второй — аккаунты читателей с подтверждением email и ролями. Сам API при этом остался прежним: один эндпоинт, который отдаёт все книги сразу. Четыре записи это выдерживали спокойно, одиннадцать — уже с натяжкой, а интерфейс к тому же просит поиск, фильтр по статусу и страницы. Четыре задачи — поиск, фильтр, страницы и честные ошибки — решаются в том же сценарии сайта: фильтры и пагинация — внутри graphql-узла, валидация — условиями, а отладка — dry-run’ом до публикации и журналом прогонов после.
Все файлы — в репозитории dynapi-vue-admin, ветка step-6-api. Она продолжает step-5-accounts: сначала пройдите шаги первых двух статей.
Шаг 1. Контракт вместо массива
В первой статье эндпоинт /api/books отвечал голым массивом — интерфейс брал его как есть. Теперь у эндпоинта есть контракт. Вход — строка запроса:
GET /api/books?status=on_loan&page=1
Выход — конверт:
{
  "items": [
    { "id": "...", "title": "Двенадцать стульев", "author": "Илья Ильф, Евгений Петров", "year": 1928, "status": "on_loan" }
  ],
  "total": 4,
  "pages": 1
}
items — страница данных, total — число книг с учётом фильтров, pages — сколько всего страниц, по 5 книг на каждой. Конверт нужен потому, что из массива текущей страницы интерфейс не узнает общее число записей, а без него не нарисуешь пагинатор.
Шаг 2. Фильтры внутри graphql-узла
За фильтры отвечает graphql-узел. Текст запроса статичен, а всё переменное уезжает в variables_expr — одну expr-строку, которая строит карту переменных целиком:
{
  "id": "a_q",
  "type": "action",
  "data": {
    "action_type": "graphql",
    "on_error": "stop",
    "config": {
      "query": "query($status: String, $q: String) {\n  books(limit: 5, orderBy: [{field: YEAR, direction: DESC}], search: $q, where: {status: {eq: $status}}) {\n    id title author year status\n  }\n  booksCount(search: $q, where: {status: {eq: $status}})\n}",
      "variables_expr": "{ \"status\": query.status != nil && query.status != \"\" ? query.status : nil, \"q\": query.q != nil && query.q != \"\" ? query.q : nil }",
      "result_key": "q",
      "secret_vars": []
    }
  }
}
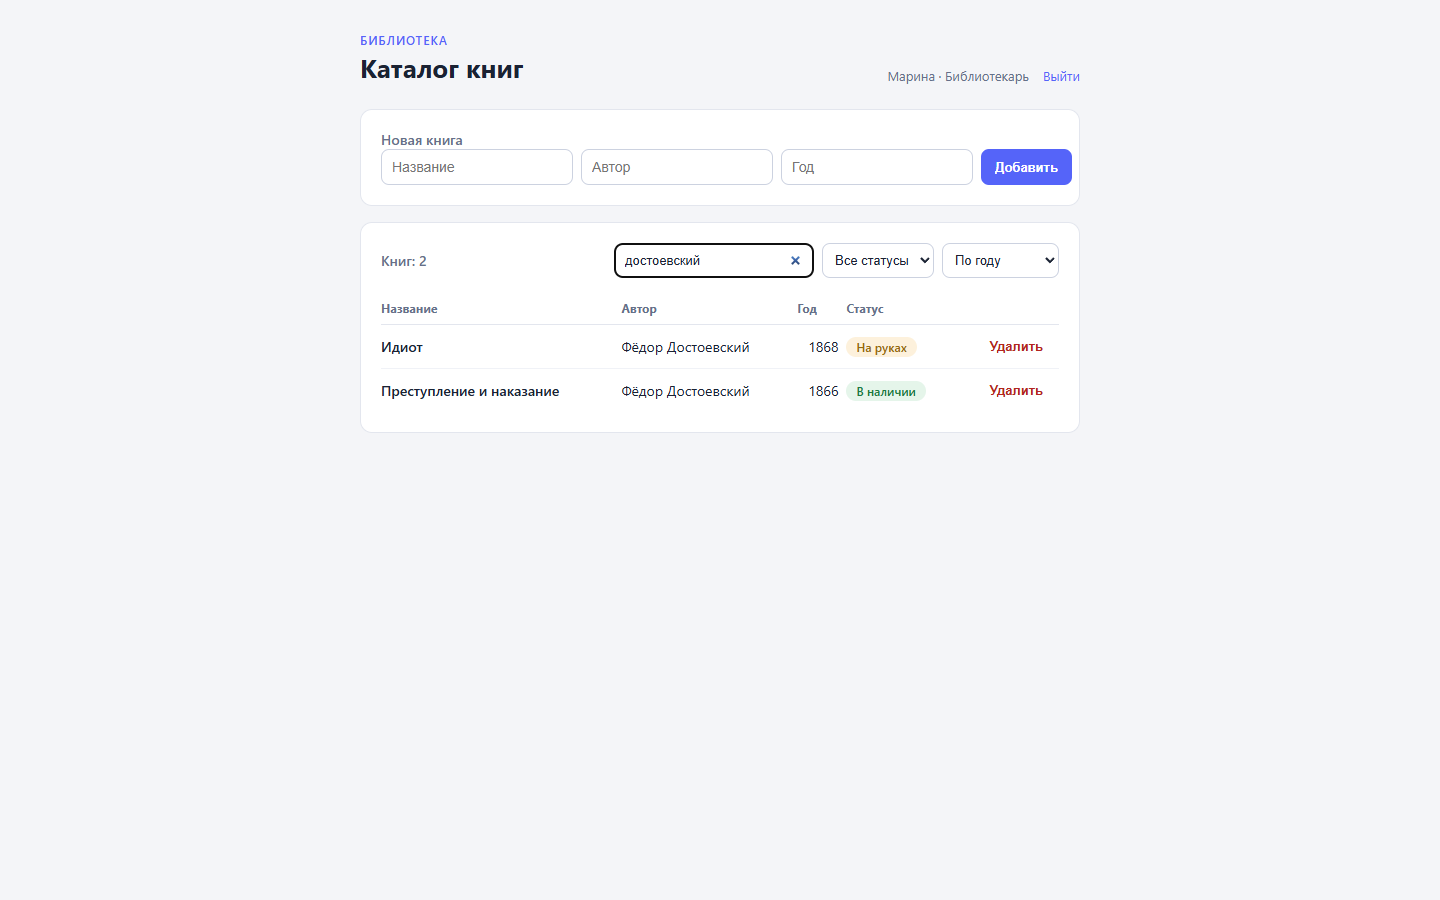
Здесь работают три механизма. query.<имя> — это параметры строки запроса GET-сценария: открыли /api/books?status=on_loan, и в query.status лежит on_loan. Аргумент search ищет по строковым полям записи без учёта регистра, так что q=булгаков находит книги и по фамилии, и по названию. И главное — пустой параметр не становится фильтром: гвард != nil && != "" превращает «не было или пусто» в nil, переменная уходит в запрос как null, а null-переменную платформа трактует как «оператор не применён» — условие where не применяется. Запрос остаётся один на все случаи, без ветвления на «фильтр задан — один запрос, не задан — другой». Аргументы offset и field появятся в следующих двух шагах: пагинация и сортировка добавят свои ключи в ту же variables_expr.
Несуществующий статус в адресе — это пустой items с нулевым total: честный ответ на запрос, а не ошибка.
Историческая справка: демо-ветка step-6-api собрана Liquid-вставками прямо в тексте запроса (offset: {{ offset }}) и Liquid-строками в variables ("status": "{{query.status}}"). С v1.4.16 это работает только для variables — Liquid из текста запроса удалён из движка: запрос со вставками не пройдёт проверку и упадёт с «query does not parse». Текст запроса держат статичным, а данные передают через variables_expr.
Шаг 3. Страница в offset
Пагинация собирается из двух чисел: сколько записей на странице (в демо зафиксировано 5) и какую страницу просят. GraphQL-аргумент offset — это номер страницы, пересчитанный в сдвиг. Считает его compute-узел — чистый expr-шаг, который кладёт значение в results, и его видят все узлы ниже:
{
  "id": "k_page",
  "type": "action",
  "data": {
    "action_type": "compute",
    "config": {
      "expr": "let p = number(query.page) ?? 1; p < 1 ? 1 : p",
      "result_key": "page"
    }
  }
}
number() строго приводит строку к числу: мусор вроде ?page=abc даёт nil, и ?? 1 поднимает его до первой страницы; отрицательные и дробные номера до GraphQL не доезжают. Сдвиг подставляет variables_expr graphql-узла из шага 2 — к карте добавляется один ключ:
"variables_expr": "{ ..., \"offset\": (results.page - 1) * 5 }"
Вторую половину считает respond-узел, собирающий конверт из результата graphql-узла. Число страниц считает ещё один compute, собирает конверт body_expr:
{
  "id": "k_pages",
  "type": "action",
  "data": {
    "action_type": "compute",
    "config": {
      "expr": "let t = number(results.q.booksCount) ?? 0; int((t + 4) / 5)",
      "result_key": "pages"
    }
  }
}
{
  "id": "a_out",
  "type": "action",
  "data": {
    "action_type": "respond_json",
    "config": {
      "body_expr": "{ \"items\": results.q.books, \"total\": results.q.booksCount, \"pages\": results.pages }",
      "status": 200
    }
  }
}
booksCount — автосгенерированное поле-спутник списка: оно принимает те же where и search, поэтому считает отфильтрованные книги, а не весь каталог. Число страниц — округление (total + 4) / 5 вверх: int() обрезает дробную часть. В body_expr список встраивается как данные — без | json и без запятой-хореографии, невалидный JSON невозможен.
Историческая справка: демо-ветка считала offset Liquid-ом прямо в тексте запроса ({% assign page = query.page | plus: 0 %}…) и собирала конверт body_template-ом с | json и целочисленным делением total + 4. С v1.4.16 не осталось ни того, ни другого: Liquid из текста запроса удалён из движка, а body_template «JSON-ответа» стал статичной строкой — такая сборка уехала бы клиенту буквально, с {% if %} внутри. Математику считают compute-узлы, тела кодирует body_expr.
Шаг 4. Сортировка по белому списку
Аргумент orderBy принимает не строку, а перечисление — TITLE, AUTHOR, YEAR. Перечисление защищает от опечаток, но чужое значение в запросе даст ошибку GraphQL вместо данных, поэтому параметр sort проходит через белый список — ещё один compute-узел:
{
  "id": "k_field",
  "type": "action",
  "data": {
    "action_type": "compute",
    "config": {
      "expr": "query.sort == \"title\" ? \"TITLE\" : query.sort == \"author\" ? \"AUTHOR\" : \"YEAR\"",
      "result_key": "field"
    }
  }
}
Любое неизвестное значение сворачивается к сортировке по году. Готовое перечисление уезжает в запрос через variables_expr: "field": results.field — типизированное значение вместо сплайсинга в тексте.
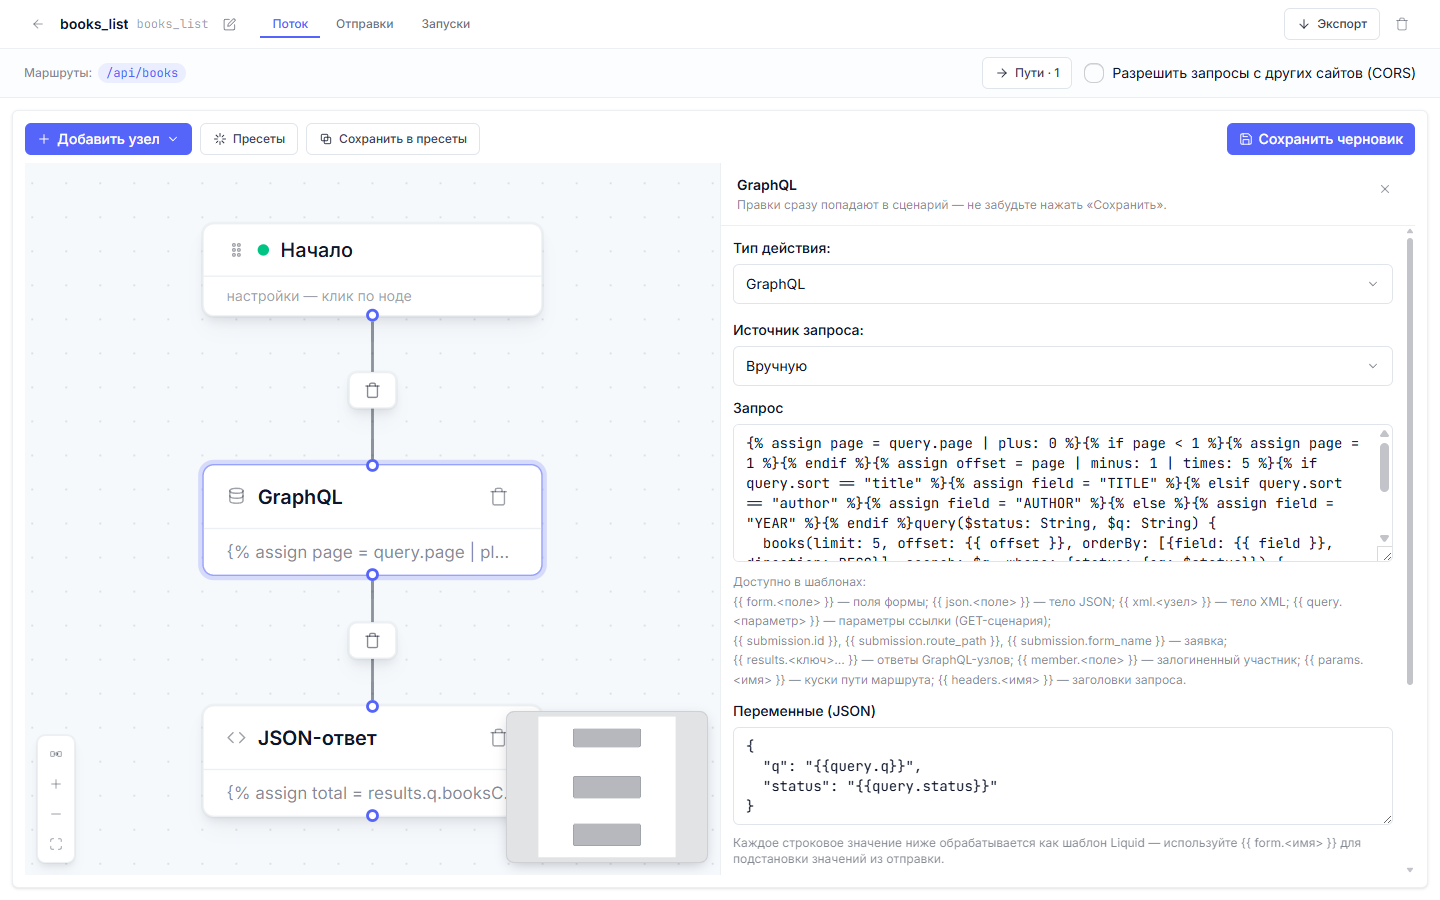
Историческая справка: на скриншоте ниже — цепочка {% if %}/{% elsif %} с assign в тексте graphql-узла, так была собрана демо-ветка. С v1.4.16 Liquid в тексте запроса удалён из движка, и такой узел проверку не пройдёт; текст держат статичным, а сортировку передают переменными.
Шаг 5. Ошибки, которые можно показать
На POST /api/books/add встают условия-гейты. Первые два требуют непустые название и автора:
{
  "id": "c_title",
  "type": "condition",
  "data": {
    "predicate": {
      "combinator": "and",
      "clauses": [
        { "field": "json.title", "operator": "matches", "value": "\\S" }
      ]
    }
  }
}
Регулярное выражение \S требует хотя бы один непробельный символ, так что и пустое поле, и строка из пробелов уходят в ветку else. Следующий гейт проверяет год, если он пришёл: операторы gt и lt сравнивают численно, и диапазон 1800–2100 отсеивает опечатки и фантастические годы. Каждый отказ отвечает кодом 400 с именем поля и сообщением:
{
  "id": "a_err_year",
  "type": "action",
  "data": {
    "action_type": "respond_json",
    "config": {
      "status": 400,
      "body_template": "{\"error\": \"VALIDATION\", \"field\": \"year\", \"message\": \"Год должен быть числом от 1800 до 2100\"}"
    }
  }
}
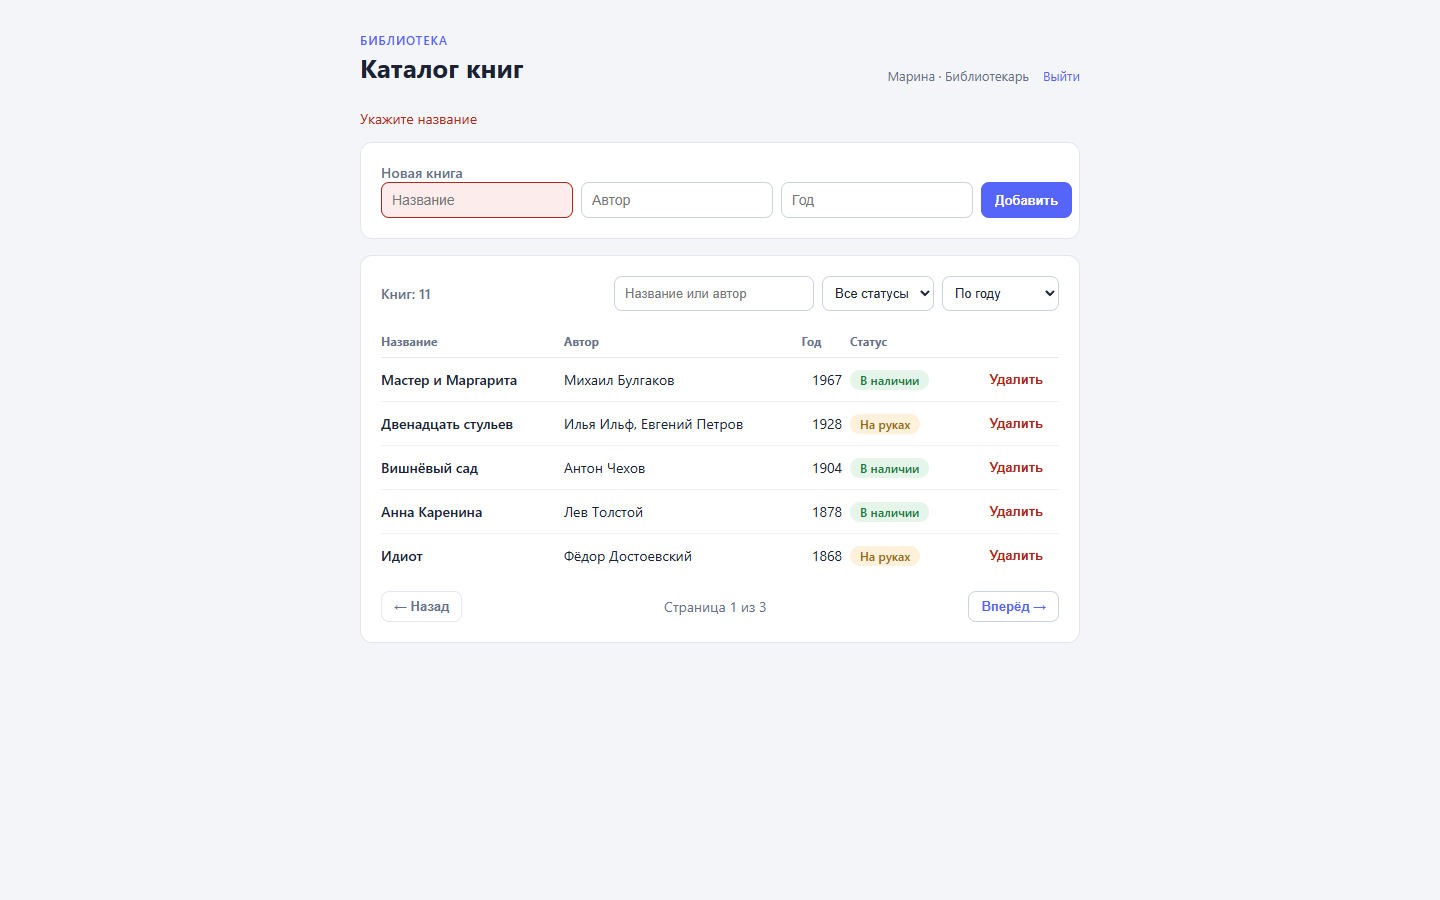
Интерфейс при этом освобожден от догадок: атрибут required с полей убран, форма отправляет что есть, а сценарий возвращает конкретику. Приложение читает field и message из ответа и подсвечивает нужное поле:
if (!res.ok) {
  const data = await res.json().catch(() => null);
  if (res.status === 400 && data?.field) {
    invalidField.value = data.field;
    serverMessage.value = data.message ?? "Проверьте заполнение полей.";
  }
  return;
}
Контракт валидации живёт на сервере, в сценарии. Интерфейс, мобильный клиент или телеграм-бот получат те же сообщения, не дублируя проверки.
Шаг 6. Отладка до и после публикации
Сценарий с ветвлением надо проверять до публикации — тем же flowctl dryrun, что в первых статьях. В контексте кладём мок результата graphql-узла, чтобы respond-узел собрал конверт из настоящих чисел:
{
  "method": "GET",
  "graphqlResults": {
    "q": { "books": [{ "title": "Мы", "year": 1920 }], "booksCount": 8 }
  }
}
Отчёт показывает оба узла зелёными и собранный ответ:
directives (1):
  - {"body": "{\"items\": [{...}], \"total\": 8, \"pages\": 2}", "status": 200}
GraphQL внутри dry-run не исполняет — вместо запроса подставляется мок. Синтаксис сгенерированного запроса покажет только живой запуск — его принимает журнал прогонов.
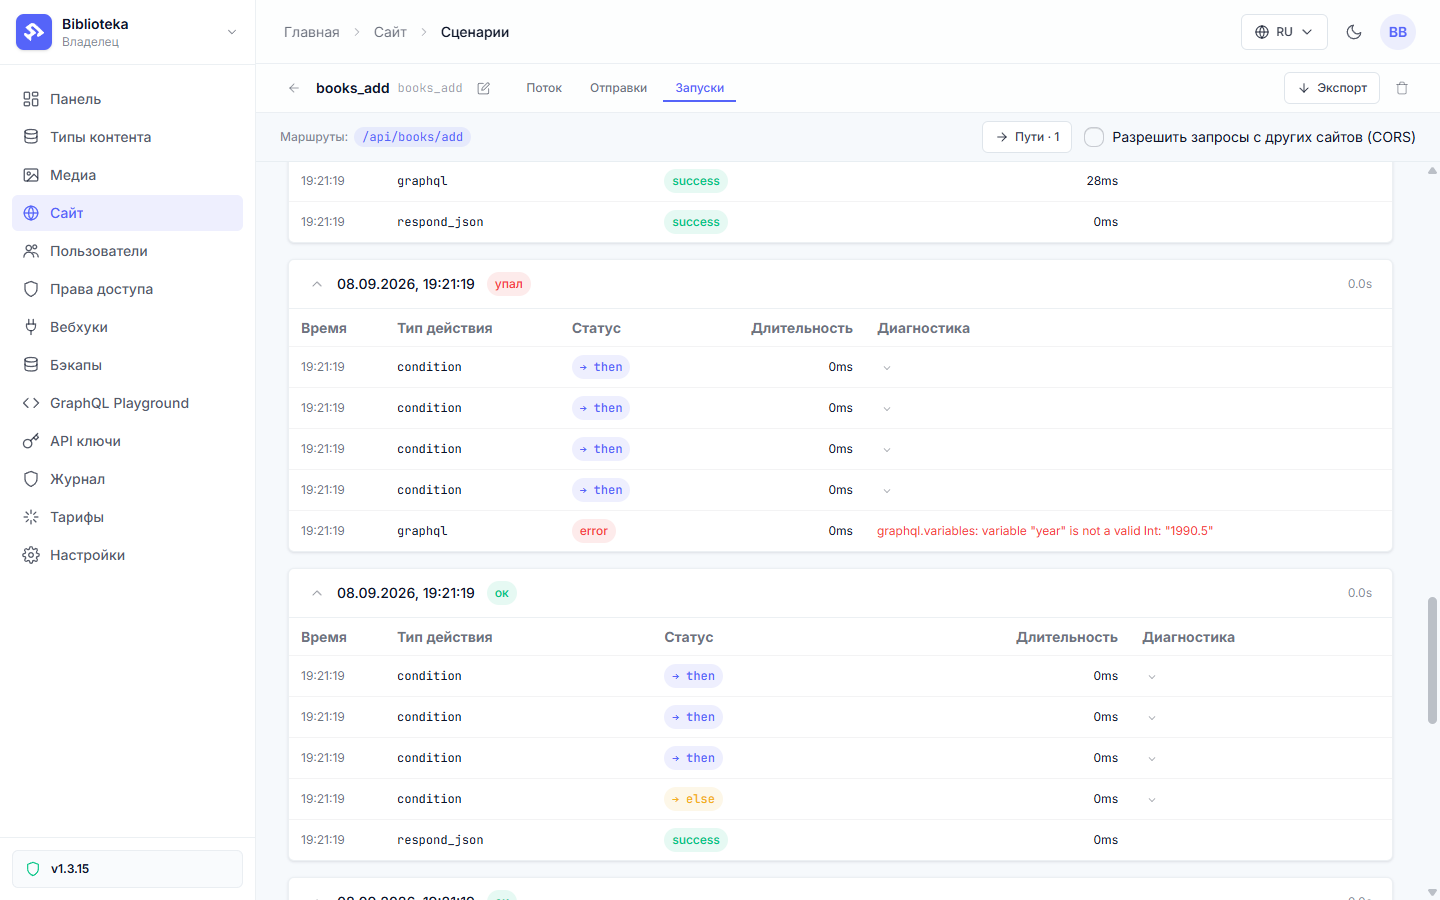
Журнал живёт на вкладке «Запуски» (или в flowctl runs <slug>) и хранит каждый запуск: какие условия в какую ветку ушли и где узел ошибся. Вот история, которая случилась при отладке демо: в поле года отправили 1990.5. Условия диапазона пропустили значение — дробное число в границах. Следующий узел упал:
node                   type              runs  errors      avg  last
a_create               graphql              2       1      14ms  ✗

last error per failing node:
  a_create: graphql.variables: variable "year" is not a valid Int: "1990.5"
Хитрость в том, что клиент увидел успех: 201 и {"ok": true, "id": ...}. Когда сценарий обрывается без respond-узла, платформа отвечает стандартным эхо отправки формы — а книга в каталоге так и не появилась. Расхождение между ответом и данными нашлось в журнале: красный узел с текстом ошибки. Лечение — одна клауза в условие года:
{ "field": "json.year", "operator": "matches", "value": "^\\d{4}$" }
Что осталось за кадром
Маршрут удаления книги не изменился со второй статьи: гейт роли и respond_json 403 построены на тех же условиях, и валидация запроса встраивается в него по образцу пятого шага. Ограничение частоты запросов тоже живёт не в сценарии: это настройка проекта из лимитов тарифа, отдельного лимита на маршрут нет.
Дальше по циклу — файлы и медиа: как дать каталогу обложки и не выйти за квоту хранилища. Все .dynflow.json этой статьи лежат в ветке step-6-api, применяются командой flowctl apply flows/books_list.dynflow.json --publish.
Все записи